
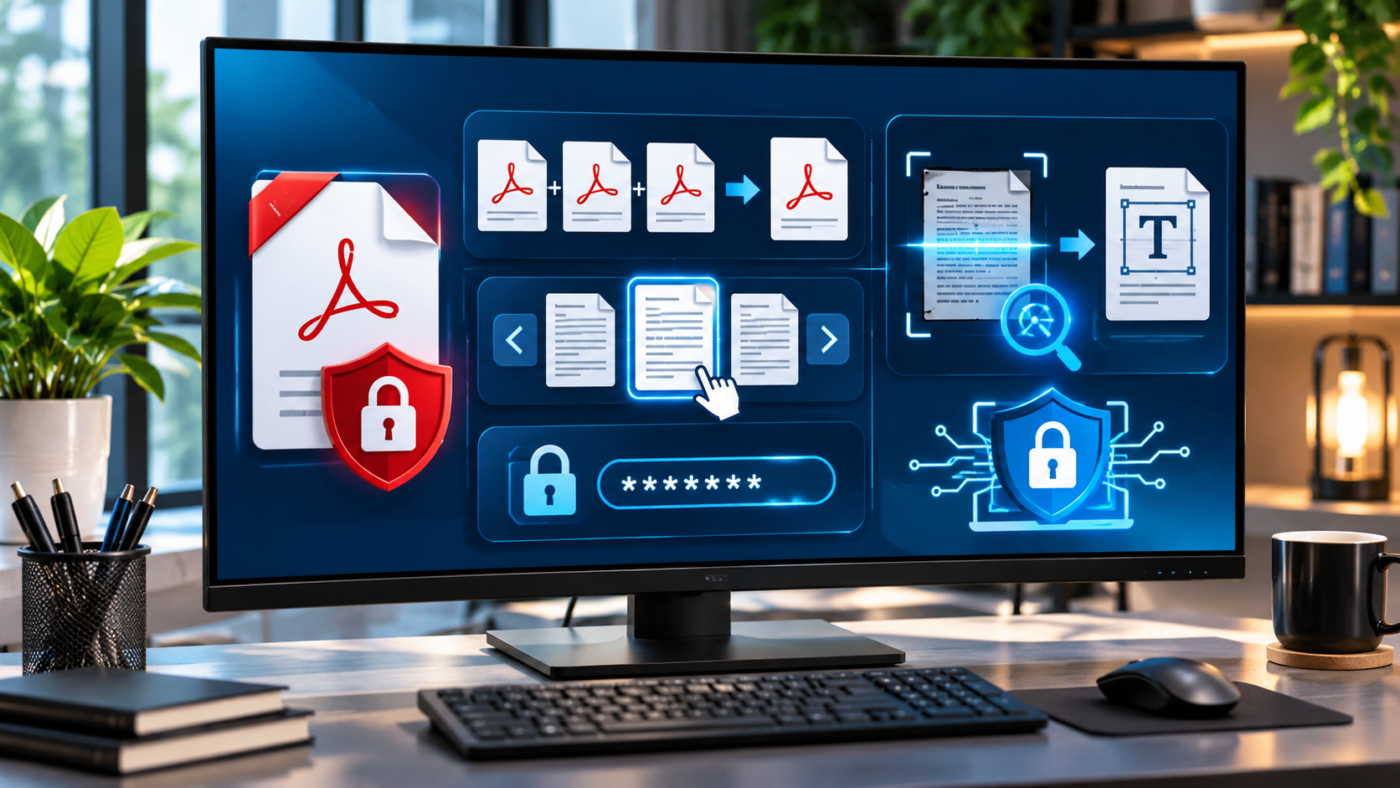
Un PDF obținut prin scanarea unei pagini poate conține doar o imagine, nu text selectabil. OCR (recunoaștere optică a caracterelor) analizează imaginea și încearcă să transforme literele în text căutabil și, în anumite condiții, editabil.
Ce face OCR
OCR identifică formele literelor din imagine și creează un strat de text. După procesare, poți căuta expresii, selecta fragmente și copia informații, în funcție de calitatea scanării și de limba recunoscută.
Pregătește documentul
Folosește o scanare clară, cu paginile drepte, contrast bun și rezoluție suficientă. Elimină umbrele și marginile inutile când este posibil. Textul foarte mic, scrisul de mână și paginile deteriorate pot reduce acuratețea.
Rulează recunoașterea textului
În versiunile Acrobat care includ instrumentul, accesează Scan & OCR și alege recunoașterea textului. Selectează limba corectă pentru document și verifică opțiunile de ieșire disponibile.
Verifică rezultatul
OCR poate confunda caractere asemănătoare, diacritice, cifre și simboluri. Verifică în special numele, seriile, sumele, datele și informațiile juridice. Nu utiliza rezultatul fără verificare pentru documente importante.
Păstrează scanarea originală
Salvează o copie separată și păstrează fișierul original ca referință. Dacă documentul conține date personale, stochează-l și distribuie-l în condiții de securitate.
Concluzie
OCR economisește timp la arhivarea documentelor, dar nu garantează transcriere perfectă. Adobe prezintă actualizările și funcțiile Acrobat în pagina oficială: https://helpx.adobe.com/acrobat/desktop/whats-new/release-notes.html
Resurse utile
Continua cu articolul organizarea si reorganizarea paginilor PDF si consulta notele oficiale Adobe Acrobat.
